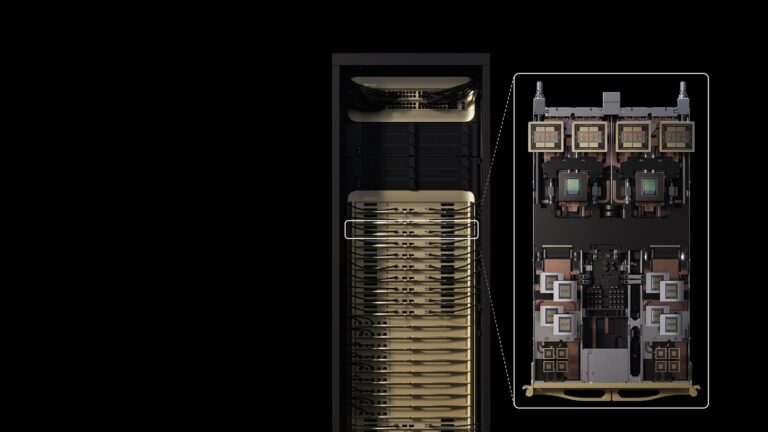
Η Nvidia έδωσε στη δημοσιότητα τον πηγαίο κώδικα ολόκληρης της πλατφόρμας Run:ai, του λογισμικού της για την κατανομή και διαχείριση μονάδων GPU σε εργασίες τεχνητής νοημοσύνης. Ο κώδικας είναι διαθέσιμος στο GitHub με την άδεια Apache 2.0, που επιτρέπει ελεύθερη χρήση, τροποποίηση και αναδιανομή. Η Run:ai εντάσσεται πλέον στην πλατφόρμα NVIDIA DSX AI Factory.
Τι κάνει η πλατφόρμα Run:ai
Η Run:ai λειτουργεί πάνω στο Kubernetes, το διαδεδομένο σύστημα ανοιχτού κώδικα για τη διαχείριση εφαρμογών σε συστοιχίες διακομιστών, χωρίς να το αντικαθιστά. Ο ρόλος της είναι να μοιράζει τις GPU ενός κοινόχρηστου cluster ανάμεσα σε διαφορετικές εργασίες: την ανάπτυξη, την εκπαίδευση μοντέλων και το inference, δηλαδή τη λειτουργία ενός ήδη εκπαιδευμένου μοντέλου για την παραγωγή απαντήσεων. Η Nvidia είχε εξαγοράσει την ισραηλινή Run:ai το 2024, και μέχρι τώρα η πλατφόρμα διατίθετο ως εμπορικό προϊόν.
Όπως περιγράφει το MarkTechPost, το σύστημα αποτελείται από ένα κεντρικό επίπεδο ελέγχου, που αναλαμβάνει την υποβολή εργασιών, τη διαχείριση πόρων και την παρακολούθηση, και από υπηρεσίες που τρέχουν σε κάθε cluster και προσθέτουν προγραμματισμό εργασιών με επίγνωση των GPU. Η πρόσβαση γίνεται μέσω web περιβάλλοντος, γραμμής εντολών, REST API και ενός διακομιστή MCP, του πρωτοκόλλου που επιτρέπει σε βοηθούς AI να συνδέονται με εξωτερικά εργαλεία.
Τέσσερα ανεξάρτητα κομμάτια
Η Nvidia χώρισε την κυκλοφορία σε τέσσερα τμήματα, τα οποία οι ομάδες μπορούν να υιοθετήσουν και μεμονωμένα:
- KAI Scheduler: ο μηχανισμός προγραμματισμού εργασιών, ήδη έργο Sandbox του οργανισμού CNCF, με δυνατότητες όπως ταυτόχρονη εκκίνηση ομάδων εργασιών, δίκαιη κατανομή πόρων στον χρόνο και επίγνωση της τοπολογίας του υλικού.
- GPU Fractioning Operator: επιτρέπει τον διαμοιρασμό μίας GPU σε κλάσματα, με τον οδηγό CUDA 13.4 να επιβάλλει αυστηρό όριο μνήμης ανά εργασία. Αντικαθιστά την παλαιότερη, κλειστή λύση της εταιρείας.
- KAI Resource Management: προσθέτει έργα, τμήματα, ποσοστώσεις και ομάδες κόμβων, ώστε για παράδειγμα να εξασφαλίζεται στο ερευνητικό τμήμα το 50% ενός cluster.
- Workload Map: βιβλιοθήκη σε Go που περιγράφει τύπους εργασιών, όπως PyTorchJob, RayCluster και υπηρεσίες KServe.
Η Nvidia δεν δημοσίευσε μετρήσεις επιδόσεων για την πλατφόρμα συνολικά. Μαζί με αυτήν κυκλοφορούν δύο συναφή έργα: το Model Streamer, που μεταφέρει τα βάρη ενός μοντέλου απευθείας στη μνήμη της GPU, και το Grove, που συντονίζει σύνθετες εργασίες inference. Σύμφωνα με δοκιμή που δημοσίευσε η Microsoft σε οκτώ εικονικές μηχανές με GPU H100 στο Azure, το Model Streamer φόρτωσε μοντέλα τρεις έως έξι φορές ταχύτερα από τον προεπιλεγμένο μηχανισμό. Υποστηρίζεται ήδη από τα δημοφιλή εργαλεία vLLM και SGLang.
Τι σημαίνει για επιχειρήσεις και προγραμματιστές
Στην πράξη, οι ομάδες υποδομών μπορούν πλέον να εξετάσουν, να τροποποιήσουν και να εγκαταστήσουν οι ίδιες την πλατφόρμα χωρίς συνδρομή. Η δωρεάν έκδοση κοινότητας, που διατίθεται από τον πηγαίο κώδικα ή μέσω Helm chart στο NGC, δεν περιλαμβάνει όμως εταιρική υποστήριξη από τη Nvidia. Οι εμπορικές εκδόσεις συνεχίζουν να προσφέρονται μέσω του NVIDIA AI Enterprise, του NVIDIA Mission Control και επιλεγμένων cloud marketplaces, ενώ οκτώ συνεργάτες, ανάμεσά τους οι Crusoe, Nebius, Mirantis και Rafay, προσφέρουν επίσης την πλατφόρμα.
Για τοπική δοκιμή αρκεί ένα script που χτίζει περίπου 50 υπηρεσίες και προσομοιώνει οκτώ GPU Tesla A10, ώστε να μη χρειάζεται πραγματικό υλικό. Απαιτούνται macOS ή Linux, ενώ σε Linux 16 GB μνήμης και 100 GB ελεύθερου χώρου. Η πλατφόρμα λειτουργεί μόνο με GPU της Nvidia, χωρίς υποστήριξη για επιταχυντές AMD ή Intel.
Σε σχέση με άλλα εργαλεία ανοιχτού κώδικα για Kubernetes, όπως τα Volcano, Kueue και YuniKorn, που εστιάζουν στον προγραμματισμό ή στις ουρές εργασιών, η Run:ai προσφέρει ολοκληρωμένη πλατφόρμα διαχείρισης πάνω από τον scheduler της. Το επόμενο ζητούμενο είναι αν θα συγκεντρώσει κοινότητα συνεισφερόντων εκτός της Nvidia, ενώ τα τέσσερα τμήματα είναι ήδη διαθέσιμα για αυτόνομη χρήση.