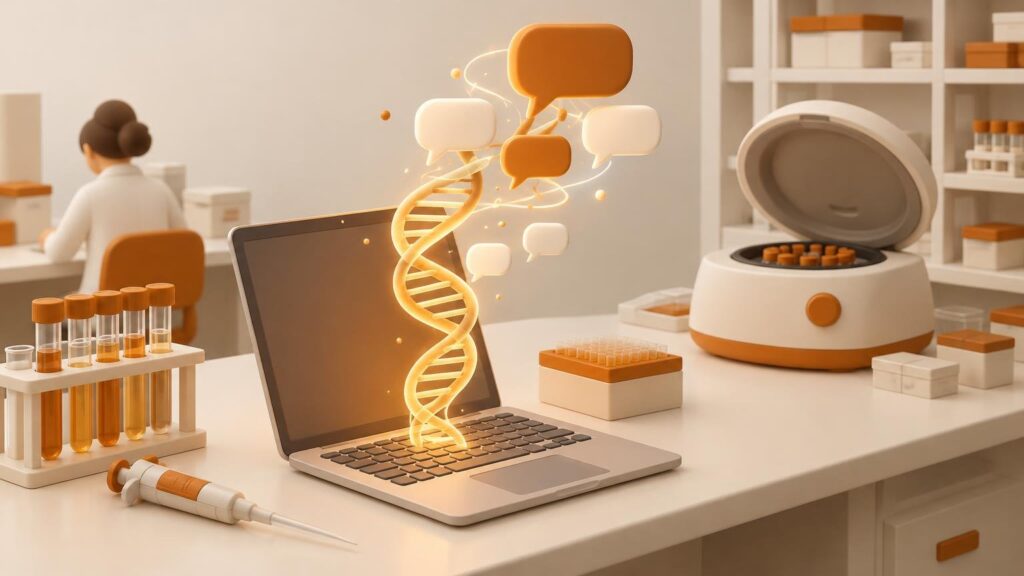
Το ανθρώπινο γονιδίωμα είναι γραμμένο με μόλις τέσσερα γράμματα, A, C, G και T, που επαναλαμβάνονται περίπου 6 δισεκατομμύρια φορές. Οι επιστήμονες το έχουν διαβάσει από την αρχή ως το τέλος, όμως για το μεγαλύτερο μέρος του ακόμη δεν ξέρουν πώς λειτουργεί. Το Carbon-X, νέο ανοιχτό μοντέλο της Hugging Face, θέλει να τους αφήσει να ρωτούν το DNA σε φυσική γλώσσα και να παίρνουν απάντηση όπως από ένα chatbot.
Η Hugging Face, την οποία πολλοί περιγράφουν ως το GitHub των μοντέλων τεχνητής νοημοσύνης, κυκλοφόρησε το μοντέλο την Πέμπτη. Το ανέπτυξε μαζί με ερευνητές της Ακαδημίας Zhongguancun στην Κίνα και του Πανεπιστημίου Federico II της Νάπολης. Ο χρήστης δίνει ένα κομμάτι γενετικής αλληλουχίας και ρωτά, για παράδειγμα, πώς μια αλλαγή σε αυτό επηρεάζει τη δραστηριότητα ενός γονιδίου ή την υγεία.
«Ξεκλειδώσαμε μια νέα δυνατότητα στα γλωσσικά μοντέλα, που στην ουσία είναι η δυνατότητα να συνομιλείς με το DNA», είπε στο WIRED ο Lewis Tunstall, ανώτερος ερευνητής της εταιρείας. Επειδή η επικοινωνία γίνεται με απλές φράσεις, ακόμη και χρήστες χωρίς τεχνικές γνώσεις, κατά τον ίδιο, μπορούν να κάνουν ερωτήσεις που κανένα άλλο εργαλείο δεν τους επιτρέπει.
Έξι γράμματα τη φορά, και καθόλου ιοί
Η ομάδα δεν ξεκίνησε από το μηδέν. Πήρε ένα υπάρχον γλωσσικό μοντέλο και διεύρυνε το λεξιλόγιό του, ώστε να διαβάζει το DNA σε ομάδες των έξι γραμμάτων. Στη συνέχεια το εκπαίδευσε σε 300 δισεκατομμύρια tokens, δηλαδή μικρά κομμάτια δεδομένων, που ανακάτευαν γενετικές αλληλουχίες, αγγλικό κείμενο και παραδείγματα που συνδέουν το DNA με βιολογικές περιγραφές.
Οι αλληλουχίες προέρχονται από θηλαστικά, μεταξύ αυτών και ανθρώπους, από άλλα σπονδυλωτά, ασπόνδυλα, φυτά, μύκητες και πρωτόζωα. Ιούς δεν περιλαμβάνουν. Όπως εξηγεί ο Tunstall, η ομάδα τους άφησε έξω σκόπιμα, για να μη χρησιμοποιηθεί το μοντέλο σε δυνητικά επικίνδυνες εφαρμογές.
Η τεχνητή νοημοσύνη έχει ήδη μπει στη γενετική. Το AlphaGenome της Google DeepMind, που βγήκε πέρσι, προβλέπει τις επιπτώσεις αλληλουχιών και μεταλλάξεων, αλλά δίνει τα αποτελέσματα σε αριθμούς και θέλει περισσότερη υπολογιστική ισχύ. Το Evo 2, του Arc Institute και της Nvidia με ακαδημαϊκούς συνεργάτες, «μιλά» τη γλώσσα του DNA και μπορεί να φτιάξει ολόκληρα γονιδιώματα. Το Carbon-X βάζει γενετικό κώδικα και ανθρώπινη γλώσσα στην ίδια συζήτηση.
Μικρό μοντέλο, για να μη βγαίνουν τα δεδομένα των ασθενών
Οι ερευνητές δεν μπορούν να ανεβάζουν ελεύθερα ευαίσθητα δεδομένα ασθενών στα μεγάλα εμπορικά μοντέλα. Γι’ αυτό η ομάδα σχεδίασε το Carbon-X με 14 δισεκατομμύρια παραμέτρους, τις εσωτερικές ρυθμίσεις που μαθαίνει ένα μοντέλο κατά την εκπαίδευση. Είναι αρκετά μικρό για να τρέχει στον υπολογιστή του χρήστη, ακόμη και σε laptop. Τίποτα δεν στέλνεται στη Hugging Face ή σε άλλη εταιρεία, λέει ο Tunstall.
Υπάρχει όμως όριο. Το μοντέλο δέχεται αλληλουχίες περίπου 50.000 ζευγών βάσεων, άρα κανείς δεν μπορεί να του δώσει ολόκληρο γονιδίωμα. Οι ερωτήσεις αφορούν μικρά κομμάτια κάθε φορά.
Μία από τις πιο χρήσιμες εφαρμογές είναι να ξεχωρίζει αν μια μετάλλαξη είναι αθώα ή προκαλεί ασθένεια. Από αυτή την απάντηση εξαρτάται ο σχεδιασμός στοχευμένων φαρμάκων και γονιδιακών θεραπειών: αν μια θεραπεία στοχεύσει λάθος μετάλλαξη, μπορεί να μην κάνει τίποτα ή να προκαλέσει ζημιά. Η εταιρεία βλέπει και ένα μέλλον όπου οι ίδιοι οι ασθενείς θα το χρησιμοποιούν για να καταλάβουν το γονιδίωμά τους.
Η κυκλοφορία έρχεται λίγες εβδομάδες αφού η Nvidia συμφώνησε τον Σεπτέμβριο να εξαγοράσει τη Hugging Face για σχεδόν 13 δισεκατομμύρια δολάρια. Οι δημιουργοί του Carbon-X πάντως προειδοποιούν ότι δεν έχουν ελέγξει ακόμη τις προβλέψεις του με πραγματικά πειράματα σε εργαστήριο, οπότε δεν μπορούν να πουν πόσο ακριβείς είναι.