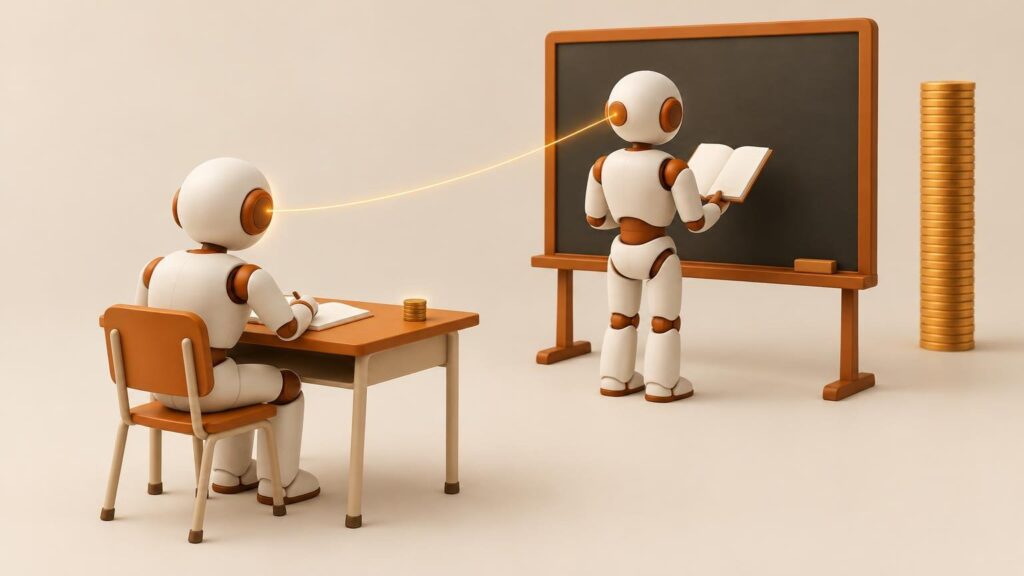
Ένας δάσκαλος που κρατά ήδη τη λύση στο χέρι μπορεί να κόψει δρόμο από σημεία που ο μαθητής του δεν θα βρει ποτέ μόνος. Από αυτή την απλή παρατήρηση ξεκινά το JOLT, μια νέα μέθοδος εκπαίδευσης γλωσσικών μοντέλων από ερευνητές της Perplexity και της Nvidia. Η ιδέα είναι να εκπαιδεύεται και ο δάσκαλος, ώστε οι οδηγίες του να μένουν κάτι που ο μαθητής μπορεί πράγματι να ακολουθήσει.
Το όνομα βγαίνει από τα αρχικά του Joint On-policy Learning and Teaching. Η μέθοδος αφορά το post-training, δηλαδή το στάδιο μετά την αρχική εκπαίδευση, όπου ένα μοντέλο μαθαίνει να λύνει καλύτερα συγκεκριμένα προβλήματα, από μαθηματικά μέχρι εργασίες σε τερματικό υπολογιστή.
Μία βαθμολογία για ολόκληρη την προσπάθεια δεν φτάνει
Οι δημοφιλείς μέθοδοι ενισχυτικής μάθησης, όπως το GRPO, δίνουν στο μοντέλο έναν βαθμό ανά προσπάθεια: πέτυχε ή απέτυχε. Το μοντέλο δεν μαθαίνει ποια κομμάτια της απάντησής του βοήθησαν και ποια όχι. Σε μεγάλες εργασίες που εκτελεί μόνος του ένας AI agent, οι επιτυχίες είναι σπάνιες, οπότε η μάθηση προχωρά αργά.
Μια λύση είναι η απόσταξη (distillation): ένα ισχυρότερο μοντέλο-δάσκαλος βαθμολογεί κάθε token, κάθε μικρό κομμάτι κειμένου που γράφει ο μαθητής. Η παραλλαγή OPSD καταργεί τον ξεχωριστό δάσκαλο. Το ίδιο μοντέλο γίνεται δάσκαλος όταν του δίνεται «προνομιακή» πληροφορία, για παράδειγμα μια επαληθευμένη λύση.
Εκεί εντοπίζουν το πρόβλημα οι ερευνητές. Ο δάσκαλος που ξέρει την απάντηση μπορεί να προτείνει βήματα που ο μαθητής, χωρίς την απάντηση, δεν μπορεί να φτάσει. Στις δοκιμές τους στα μαθηματικά, η απόσταση ανάμεσα σε δάσκαλο και μαθητή στο OPSD μεγάλωνε όσο προχωρούσε η εκπαίδευση.
Ο δάσκαλος βαθμολογείται κι αυτός
Στο JOLT ένα κοινό μοντέλο παίζει και τους δύο ρόλους ταυτόχρονα. Ο δάσκαλος βλέπει την προνομιακή πληροφορία και μαθαίνει από το αν πετυχαίνει, με μια ποινή που τον κρατά κοντά στον τρόπο σκέψης του μαθητή. Ο μαθητής βλέπει μόνο την εργασία και μαθαίνει από τη βαθμολογία του δασκάλου, token προς token, πάνω στις δικές του προσπάθειες. Η εκδοχή JOLT+ προσθέτει και τη βαθμολογία που παίρνει ο ίδιος ο μαθητής για το αποτέλεσμά του.
Επειδή υπάρχει ένα μόνο μοντέλο, δεν χρειάζεται δεύτερο, μεγαλύτερο, για τον ρόλο του δασκάλου. Το υλικό στο οποίο έγινε η εκπαίδευση δεν δημοσιοποιήθηκε.
Από τα μαθηματικά ως το AppWorld
Οι ερευνητές δοκίμασαν τη μέθοδο σε πέντε σενάρια, το καθένα με διαφορετικό μοντέλο βάσης και διαφορετικό είδος «κρυφής» βοήθειας για τον δάσκαλο:
- GSM8K (μαθηματικά προβλήματα σχολικού επιπέδου) με το DeepSeek-V2-Lite, όπου ο δάσκαλος ξέρει τη σωστή απάντηση.
- MATH με το Qwen3-0.6B, με πλήρεις λυμένες ασκήσεις.
- LiveCodeBench v6 (προγραμματισμός) με το Qwen3-8B σε 131 προβλήματα, με λύση που περνά τους ελέγχους ή με αποτελέσματα εκτέλεσης.
- AppWorld (εργασίες σε εφαρμογές) με το Qwen3-4B-Instruct, με περιλήψεις προηγούμενων προσπαθειών.
- Terminal-Bench 2.1 (εργασίες σε τερματικό) με το Qwen3-30B-A3B-Instruct, με ιδιωτικά αρχεία ελέγχου.
Σύμφωνα με την εργασία, το JOLT+ είχε τον υψηλότερο μέσο όρο σε όλα τα σενάρια, απέναντι στο GRPO, το OPSD και τη μέθοδο π-Distill. Η μεγαλύτερη διαφορά καταγράφηκε στο AppWorld: 72,09% επιτυχία έναντι 62,20% για το GRPO, σχεδόν δέκα μονάδες. Στα μαθηματικά MATH το κέρδος ήταν 4,2 μονάδες, στον κώδικα 3 και στο GSM8K 1,5.
Στο Terminal-Bench 2.1 τα νούμερα είναι χαμηλά για όλους. Το μοντέλο βάσης έλυνε το 5,18% των εργασιών με την πρώτη προσπάθεια. Το GRPO το ανέβασε στο 8,25% και το JOLT+ στο 10,96%. Με 32 προσπάθειες ανά εργασία, τα ποσοστά ήταν 22,81%, 30,34% και 34,83% αντίστοιχα.
Ίδια ακρίβεια με το ένα έκτο των tokens
Για όποιον πληρώνει λογαριασμό σε GPU, το πιο ενδιαφέρον νούμερο αφορά το κόστος. Στο MATH, για να φτάσει ακρίβεια 63,44%, το GRPO επεξεργάστηκε 8,4 εκατομμύρια tokens εκπαίδευσης. Η καμπύλη του JOLT δείχνει ότι χρειάζεται 1,3 εκατομμύρια, δηλαδή 6,5 φορές λιγότερα. Αν μετρηθούν μόνο τα tokens που παράγει το μοντέλο, η διαφορά φτάνει περίπου τις 13 φορές. Για στόχους ακρίβειας από 55% ως 65%, η εξοικονόμηση κυμαίνεται από 4,3 έως 7,4 φορές.
Το JOLT σταθεροποιείται επίσης ψηλότερα, κοντά στο 72%, όταν το GRPO σταματά γύρω στο 70% και το OPSD στο 62%. Η Perplexity, που έγινε γνωστή για τη μηχανή απαντήσεων και πρόσφατα έφερε το Perplexity Computer να τρέχει τοπικά στο Mac, δείχνει έτσι ότι κάνει και βασική έρευνα πάνω στην εκπαίδευση μοντέλων.
Όλα τα αποτελέσματα, όπως σημειώνει το MarkTechPost, προέρχονται από τις δοκιμές των ίδιων των ερευνητών, με ρυθμίσεις προσαρμοσμένες σε κάθε μέθοδο. Και δείχνουν ότι η βαθμολογία του ίδιου του μαθητή μετράει: χωρίς αυτήν, το απλό JOLT ξεπέρασε το GRPO στο MATH, με 72,14% έναντι 68,36%, αλλά έμεινε πίσω στο Terminal-Bench και στο AppWorld, όπου έπεσε στο 51,92%.