Ένας agent έγραψε μια ρουτίνα που σε τυχαία δεδομένα χρειαζόταν 20 μικροδευτερόλεπτα. Στα πραγματικά δεδομένα, με πλαίσιο 70.000 tokens, χρειάστηκε έως και 62 χιλιοστά του δευτερολέπτου. Το παράδειγμα είναι από την Together AI και δείχνει γιατί παρουσίασε το Together Compiler: ένα σύστημα όπου πράκτορες τεχνητής νοημοσύνης ξαναβελτιστοποιούν διαρκώς το πώς τρέχει ένα μοντέλο, όχι μία φορά.
Η εταιρεία, όπως μεταδίδει το MarkTechPost, υποστηρίζει ότι μια μηχανή εξυπηρέτησης που ρυθμίστηκε μία φορά παλιώνει γρήγορα. Το Together Compiler τρέχει ήδη σε μέρος των serverless endpoints της, δηλαδή των υπηρεσιών όπου οι πελάτες καλούν μοντέλα χωρίς να διαχειρίζονται servers.
Η κίνηση αλλάζει, ο κώδικας μένει πίσω
Η Together AI λέει ότι το προφίλ της κίνησης δεν μένει σταθερό. Σε μία χώρα τα prompts έφταναν περίπου τα 97.000 tokens, ενώ αλλού τα 70.000. Στο P90 ενός πελάτη, δηλαδή στο μήκος που ξεπερνά το 10% των αιτημάτων, η είσοδος μεγάλωσε από 18.000 σε 33.000 tokens μέσα σε τρεις ημέρες.
Υπάρχει και παγίδα στις δοκιμές. Τα τυχαία δεδομένα ενεργοποίησαν 13 έως 38% περισσότερους «ειδικούς» σε μοντέλα τύπου MoE (mixture of experts, όπου κάθε αίτημα περνά μόνο από μέρος του δικτύου) απ’ όσους η πραγματική κίνηση. Γι’ αυτό ο κώδικας που φαίνεται γρήγορος στο εργαστήριο μπορεί να αποτυγχάνει στην παραγωγή.
Μία μηχανή που δεν σβήνει ποτέ
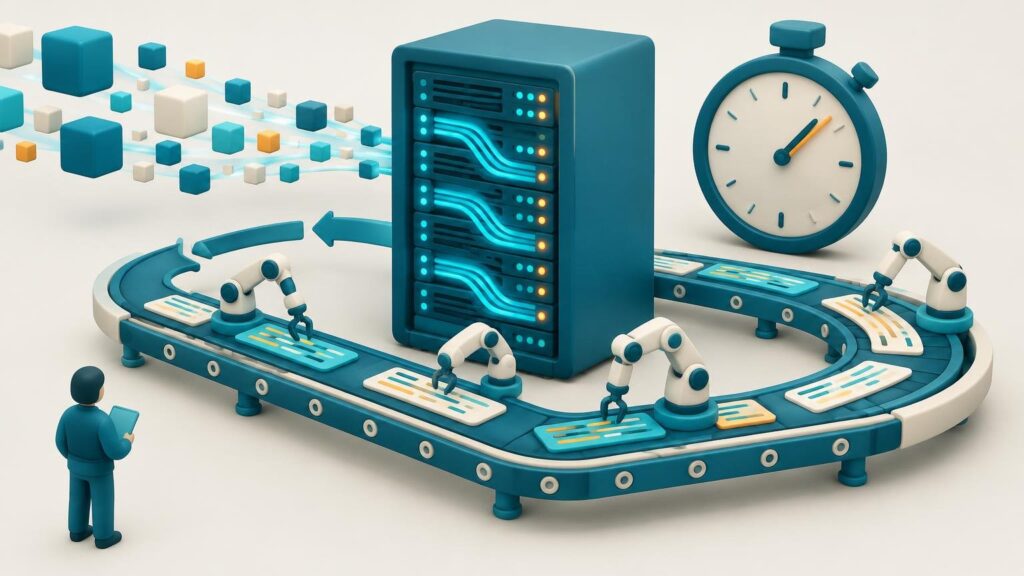
Οι περισσότεροι βρόχοι με agents επανεκκινούν το vLLM, το SGLang ή το TensorRT-LLM σε κάθε πείραμα. Η εκκίνηση του MiniMax M3.1 Flash στο TensorRT-LLM παίρνει 761 δευτερόλεπτα, σύμφωνα με την ομάδα. Στο Together Compiler η μηχανή ξεκινά μία φορά, οι agents στέλνουν υποψήφιο κώδικα και ο server ανταλλάσσει τη συνάρτηση εκτέλεσης εν ζωή. Η εταιρεία αναφέρει 252 φορές περισσότερα πειράματα ανά agent σε σχέση με επανεκκίνηση.
Η μέτρηση γίνεται σε δύο επίπεδα: ένα γρήγορο με 12 στρώματα του μοντέλου για πρώτο φιλτράρισμα και ένα αργό με 60 για επιβεβαίωση. Έτσι δοκιμάστηκαν 1.354 υποψήφιοι αντί για 168, και βρέθηκε λύση 7,2% ταχύτερη. Πριν δουλέψουν οι agents, ένα μοντέλο κόστους κατατάσσει τους τρόπους κατανομής του μοντέλου στις GPU. Στο Kimi K3 βρήκε διάταξη με έως 24% περισσότερα tokens ανά δευτερόλεπτο (TPS).
Τα αποτελέσματα, από 4% έως 2,6x
Στο φορτίο AgentX του InferenceX της SemiAnalysis, η εταιρεία αναφέρει έως 2,6 φορές υψηλότερο TPS από τις καλύτερες δημοσιευμένες ρυθμίσεις, με λιγότερο από 24 ώρες ανά περίπτωση και το πολύ δύο κόμβους. Οι αριθμοί είναι αυτοαναφερόμενοι. Με batch size 1, TPS ανά χρήστη στο P90:
- MiniMax M3.1 Flash σε B200: 1.111 έναντι 633
- DeepSeek v4.1 Flash σε GB300: 1.205 έναντι 943
- GLM 5.3 σε B200: 417 έναντι 329
- Kimi K3 σε GB300: 450 έναντι 423
- GLM 5.3 σε MI355X της AMD: 480 έναντι 463
Η διαφορά είναι μεγάλη στο πρώτο μοντέλο και περίπου 4% στο τελευταίο. Στο Llama 1B το σύστημα ξεπέρασε, κατά τη Together AI, τα megakernels της Hazy Research, το Mirage και βάσεις με CUDA graphs έως 1,7 φορές. Σε οκτώ επιστημονικά μοντέλα έδωσε επιτάχυνση 1,5x έως 6,4x με πανομοιότυπα αποτελέσματα. Το Claude Code με εντολή /goal έφτασε 1,2x έως 4,4x και απέτυχε στο AIFS-ENS 2.0.
Οι agents τα πήγαν καλύτερα χωρίς τις συμβουλές ειδικών
Μια βάση γνώσης φτιαγμένη από ειδικούς έδωσε 25 έως 31% μικρότερη επιτάχυνση μετά από 12 ώρες. Agents που πήραν μόνο την οδηγία να κάνουν τη διαδικασία «όσο πιο γρήγορη γίνεται» ξεπέρασαν τις στρατηγικές των ειδικών: 6,2x έναντι 4,9x μετά από 10 δοκιμές. Τα εξειδικευμένα logging έφαγαν έως 43% των κλήσεων εργαλείων. Γι’ αυτό η Together AI δίνει πλέον στους agents τον ωμό κώδικα της μηχανής και όχι ενδιάμεση αναπαράσταση.
Πηγή: MarkTechPost