Ένας AI agent που απαντά γρήγορα στο ερώτημα «πόσα ήταν τα έσοδα;» δεν χρησιμεύει σε τίποτα, αν ο αριθμός είναι λάθος. Από αυτή την παρατήρηση ξεκινά η Nvidia για το Auto Ontology, μια βιβλιοθήκη που κυκλοφόρησε με ανοιχτή άδεια Apache 2.0, όπως αναφέρει το MarkTechPost.
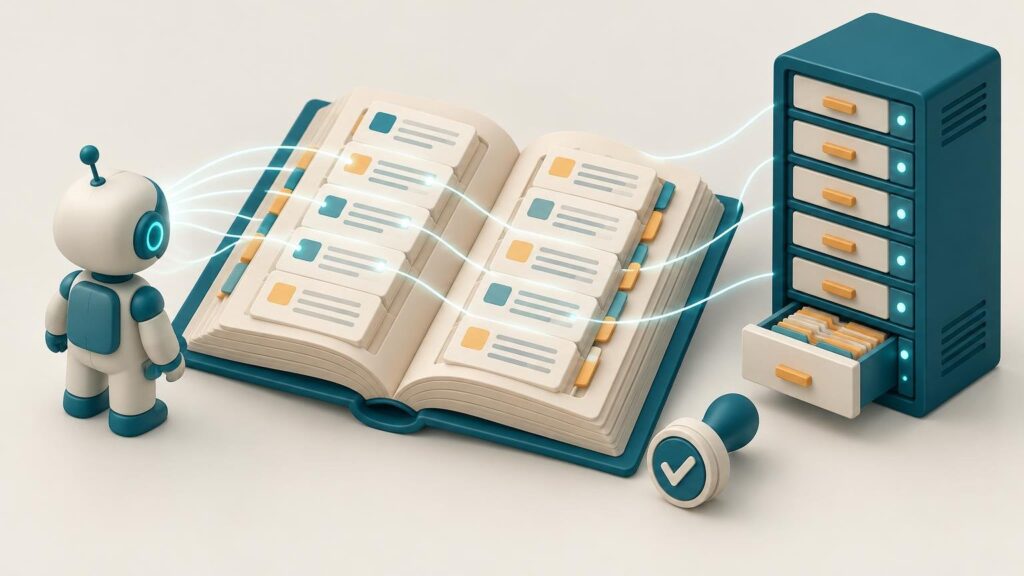
Το εργαλείο στήνει ένα «σημασιολογικό επίπεδο» ανάμεσα στον agent και την αποθήκη δεδομένων της επιχείρησης. Με απλά λόγια, είναι ένα λεξικό που λέει στον agent πού βρίσκονται τα δεδομένα, τι σημαίνει κάθε πεδίο, αν πρέπει να το χρησιμοποιήσει, πώς και από πού προέρχεται. Ο agent γράφει τα ερωτήματά του σε SQL, τη γλώσσα των βάσεων δεδομένων, πάνω σε πιστοποιημένους ορισμούς και όχι με εικασίες από τα ονόματα των στηλών.
Από τα μεταδεδομένα στο λεξικό
Το Auto Ontology φτιάχνει μια πρώτη εκδοχή αυτού του λεξικού από τα μεταδεδομένα της εταιρείας. Η σελίδα της Nvidia για προγραμματιστές την περιγράφει ως σημείο εκκίνησης: οι ειδικοί του επιχειρηματικού τομέα εξακολουθούν να τη δοκιμάζουν, να τη διορθώνουν και να την πιστοποιούν. Οι πιστοποιημένες διορθώσεις επιστρέφουν στο σύστημα και το βελτιώνουν.
Οι πηγές δεδομένων μπορεί να είναι Databricks, Postgres, Snowflake ή DuckDB. Το προεπιλεγμένο γλωσσικό μοντέλο είναι το nvidia/nemotron-3-nano-30b-a3b, αλλά δουλεύει με οποιοδήποτε endpoint συμβατό με το API της OpenAI. Τρέχει τοπικά με Docker Compose ή σε Kubernetes με Helm.
Εννέα εργαλεία μόνο για ανάγνωση
Οι agents φτάνουν στο σύστημα μέσω MCP, ενός προτύπου που επιτρέπει σε agents να συνδέονται με εξωτερικά εργαλεία. Ο διακομιστής προσφέρει εννέα εργαλεία μόνο για ανάγνωση. Το ask_question επιστρέφει χωριστά την απάντηση, το SQL και τις γραμμές, με όριο τις 100 γραμμές. Δεν υπάρχει εργαλείο για περιήγηση στα ακατέργαστα σχήματα των βάσεων: η Nvidia το επέλεξε ώστε οι agents να περνούν πάντα από το σημασιολογικό επίπεδο. Κάθε κλήση φέρει τα δικαιώματα του χρήστη που έχει συνδεθεί.
Ένας αριθμός και καμία μέτρηση ακρίβειας
Η Nvidia αναφέρει ότι ο χρόνος δημιουργίας ενός ontology μειώθηκε κατά 90% στις δικές της δοκιμές. Είναι δική της μέτρηση και όχι ανεξάρτητη επιβεβαίωση. Αποτελέσματα ακρίβειας στη μετατροπή ερωτήσεων σε SQL δεν έχει δημοσιεύσει.
Στο χώρο αυτό υπάρχει το auto-ontology-eval, ένα ξεχωριστό πλαίσιο αξιολόγησης με σύνολα όπως τα BIRD Dev (1.534 ερωτήσεις) και Mini-Dev (500 ερωτήσεις). Συγκρίνει έναν agent που βλέπει μόνο το σχήμα της βάσης με έναν που στηρίζεται στο ontology, και βαθμολογεί με ταύτιση εκτέλεσης, χωρίς LLM ως κριτή. Περιέχει όμως εργαλείο μέτρησης, όχι αποτελέσματα. Το αποθετήριο προειδοποιεί επίσης ότι η διαφορά που μετριέται με προαιρετικά παραδείγματα αφορά και αυτά τα στοιχεία, όχι μόνο τη θεμελίωση, και ότι η δοκιμασμένη ρύθμιση περνά και τις δύο πλευρές από μοντέλο Claude. Όποιος θέλει να εμπιστευτεί το εργαλείο θα πρέπει να τρέξει μόνος του τις μετρήσεις.
Πηγή: MarkTechPost