Όταν δίνεις σε ένα γλωσσικό μοντέλο ένα πολύ μεγάλο έγγραφο, πρέπει να περιμένεις αρκετά πριν γράψει την πρώτη λέξη της απάντησης. Ερευνητές του Stanford και του UC Berkeley παρουσίασαν το TokenGate, ένα πρόσθετο που μειώνει αυτή την αναμονή: το μοντέλο μαθαίνει να «ξεφυλλίζει» το κείμενο και να επεξεργάζεται πλήρως μόνο τα tokens που μετράνε. Οι ερευνητές αναφέρουν επιτάχυνση από 1,4 έως 11,3 φορές στον χρόνο μέχρι το πρώτο token, χωρίς απώλεια ακρίβειας, όπως μεταδίδει το MarkTechPost.
Γιατί το διάβασμα του εγγράφου είναι το βαρύ κομμάτι
Στη φάση που το μοντέλο διαβάζει την είσοδό του (prefill), κάθε token περνά από κάθε στρώμα του δικτύου. Το κόστος της προσοχής, του μηχανισμού που συσχετίζει τα tokens μεταξύ τους, μεγαλώνει με το τετράγωνο του μήκους. Οι μέθοδοι κλαδέματος χωρίς εκπαίδευση είναι φθηνές, αλλά χάνουν ακρίβεια όταν κόβουν πολλά tokens. Όσες αλλάζουν την αρχιτεκτονική συχνά απαιτούν εκπαίδευση από το μηδέν.
Το TokenGate παίρνει ένα έτοιμο μοντέλο και προσθέτει ένα μικρό δίκτυο-«πύλη» και προσαρμογείς LoRA με r=16. Στα πειράματα χρησιμοποιήθηκαν τα Qwen3-1.7B και Qwen3.5-2B, με κείμενα έως 128.000 tokens.
Πώς αποφασίζει τι θα κρατήσει
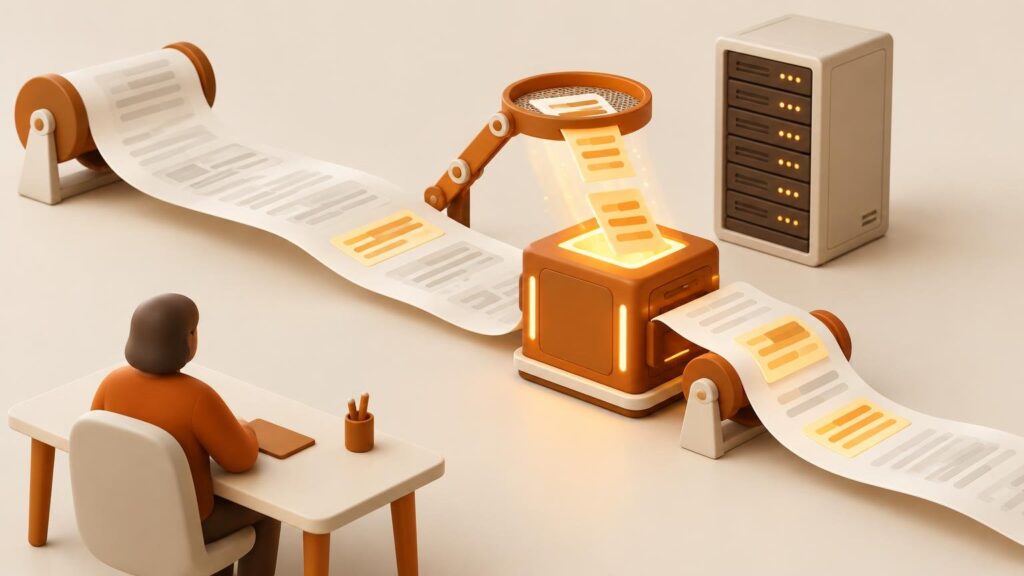
Τα πρώτα στρώματα επεξεργάζονται όλα τα tokens κανονικά. Στο στρώμα της πύλης, ένα μικρό δίκτυο βαθμολογεί κάθε token και κρατιέται μόνο όσα έχουν την υψηλότερη βαθμολογία. Τα ανώτερα στρώματα δουλεύουν μόνο με αυτά και δεν δημιουργούν καν εγγραφές στη μνήμη KV για τα υπόλοιπα. Κλαδεύεται μόνο το τμήμα του εγγράφου· η ερώτηση μένει πάντα ολόκληρη.
Το πρόβλημα είναι ότι η επιλογή των κορυφαίων tokens δεν επιτρέπει εκπαίδευση από άκρη σε άκρη. Η λύση δανείζεται το κόλπο των router στα μοντέλα Mixture-of-Experts: η βαθμολογία κάθε tokens που επιβιώνει προστίθεται ως bias στην προσοχή των επόμενων στρωμάτων. Έτσι η πληροφορία γυρνά πίσω προς τον βαθμολογητή και εκείνος μαθαίνει. Η εκπαίδευση γίνεται με απλή απώλεια επόμενου token και εναλλάσσει πλήρες και τυχαίο μέγεθος κράτησης, οπότε μία πύλη δουλεύει με διαφορετικά όρια.
Τα νούμερα
Οι ερευνητές δοκίμασαν το Qwen3-1.7B σε πέντε εργασίες: RepoBench-P, 2WikiMultihopQA, MultiNews, BioDEX και ένα τεστ «βελόνας στα άχυρα». Το συνέκριναν με έξι μεθόδους, ανάμεσά τους FastKV, GemFilter, FlexPrefill και MInference.
- Σε σχέση με πλήρη prefill: 1,4 έως 11,3 φορές ταχύτερος χρόνος μέχρι το πρώτο token και 1,5 έως 3,4 φορές χαμηλότερη μνήμη αιχμής.
- Σε σχέση με την καλύτερη από τις άλλες μεθόδους: 1,2 έως 6,4 φορές ταχύτερα και έως 2,1 φορές λιγότερη μνήμη.
- Στο 2WikiMultihopQA, με το 95% της ακρίβειας του πλήρους κειμένου, η prefill τρέχει 3 φορές πιο γρήγορα με 2,7 φορές λιγότερη μνήμη.
Το καλύτερο αποτέλεσμα, 11,3 φορές, ήρθε στο τεστ βελόνας με 16.000 tokens. Μια πύλη εκπαιδευμένη στα 16.000 έφτασε 12,8 φορές στα 32.000 και 13 φορές στα 64.000 και τα 128.000. Η μνήμη έμεινε περίπου 3,43 φορές χαμηλότερη. Τα χρονικά των εργασιών μετρήθηκαν σε μία κάρτα A100 με batch size 1.
Και σε μοντέλα με υβριδική προσοχή
Το Qwen3.5-2B συνδυάζει στρώματα Gated DeltaNet με στρώματα πλήρους προσοχής. Στο τεστ βελόνας με 32.000 tokens, το TokenGate στο στρώμα 3 έπιασε την ακρίβεια της πλήρους prefill, με 3,8 φορές ταχύτερη επεξεργασία, και ήταν 2,1 φορές πιο γρήγορο από το FastKV. Με πύλη στο στρώμα 1 ή 2 η επιτάχυνση έφτασε 7,8 φορές, με πτώση ακρίβειας έως 6%. Το FastKV, σημειώνεται, μπορεί να κλαδέψει μόνο στρώματα προσοχής.
Ένα εύρημα που οι ερευνητές αποδίδουν στη συνεκπαίδευση με το υπόλοιπο μοντέλο: ακόμη και η τυχαία επιλογή tokens δίνει καλύτερο σκορ πάνω στο μοντέλο του TokenGate, ενώ ο εκπαιδευμένος επιλογέας ξεπερνά το ευρετικό του FastKV στο ίδιο στρώμα.
Τι χρειάζεται για να δοκιμαστεί
Ο κώδικας και τα checkpoints δίνονται στο GitHub με άδεια Apache-2.0. Απαιτούνται Python 3.10+ και PyTorch 2.9+ με CUDA. Υπάρχει προαιρετικός πυρήνας FlashAttention-2 για τα απλά Qwen3, αλλιώς το σύστημα πέφτει σε FlexAttention. Η εκπαίδευση έγινε σε τέσσερις A100. Κάθε βήμα είναι 1,3 φορές πιο αργό από απλό LoRA, όμως σε τέσσερις από τις πέντε εργασίες η σύγκλιση ήρθε νωρίτερα: 1,8 ώρες A100 κατά μέσο όρο, έναντι 2,2.
Οι συγγραφείς επισημαίνουν ότι τα κέρδη των άλλων μεθόδων προέρχονται από διαφορετικές ρυθμίσεις και δεν συγκρίνονται απευθείας.
Πηγή: MarkTechPost